Ceph in een Proxmox-cluster kan VM-gegevens over lokale SSD’s van meerdere hosts verdelen en een apart SAN vervangen. Doorslaggevend is wat na hostuitval met de kopieën gebeurt: zijn quorum, vrije capaciteit en netwerk voldoende om de gewenste redundantie tijdig te herstellen? De volgende berekening onderscheidt bereikbare gegevens, automatische VM-herstarts en werkelijke hersteltijd.
Dit artikel behandelt de werking van Ceph in beheer. De concrete HPE-stuklijst vraagt een eigen hardwareontwerp; de keuze tussen Ceph, ZFS-replicatie en externe opslag vereist een afzonderlijke toepassingsvergelijking. Het basisscenario gebruikt lokale enterprise-SSD’s als afzonderlijke Ceph-OSD’s, een gerepliceerde VM-pool en de host als storingsdomein. Opstartmedia en externe back-up vallen buiten die pool.
Hoe maken lokale SSD’s VM-gegevens bereikbaar?
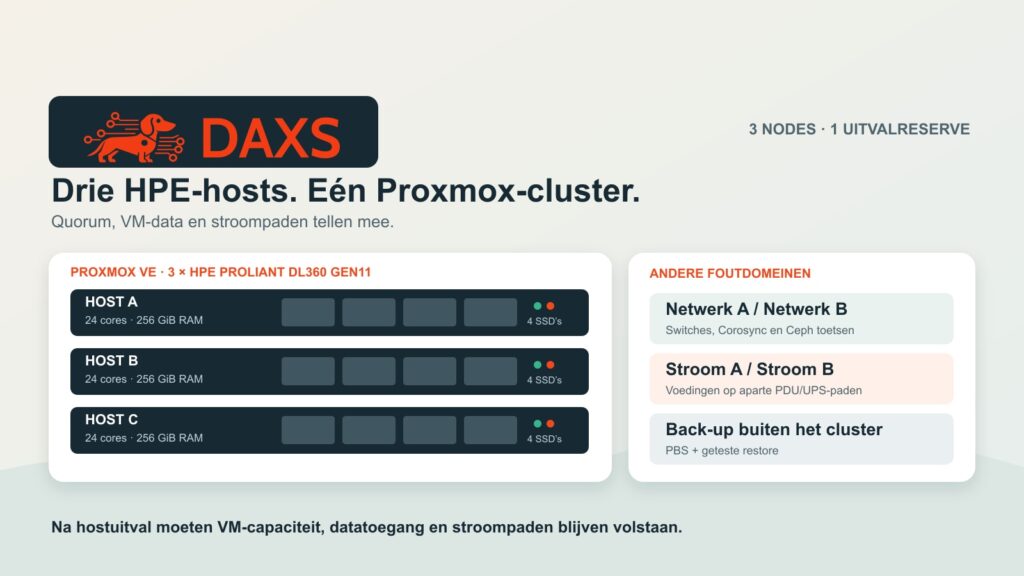
Ceph verdeelt gegevensobjecten via placement groups over OSD’s. De CRUSH-regel bepaalt op welke hosts kopieën staan. Voor dit voorbeeld kiezen we uitdrukkelijk size=3 en min_size=2: drie kopieën inclusief de primaire, met I/O bij minstens twee bereikbare kopieën. Kopieën op drie OSD’s van dezelfde host bieden geen drievoudige bescherming tegen hostuitval. Monitorquorum, OSD-status en bereikbaarheid van VM-gegevens moeten afzonderlijk worden gecontroleerd. Het Proxmox-cluster heeft voor betrouwbaar HA-quorum minstens drie stemmen nodig; Ceph-monitorquorum en VM-HA-regels komen daarbij.
Na uitval van één van precies drie hosts blijven bij juiste verdeling twee hostkopieën over. Onder de genoemde voorwaarden kan de pool gedegradeerde I/O afhandelen, maar een derde kopie in een derde hoststoringsdomein ontstaat pas na terugkeer of vervanging van een host. Met vier hosts kan Ceph die op de vierde herbouwen als ruimte en prestaties beschikbaar zijn. Dat is het praktische verschil tussen “gegevens blijven bereikbaar” en “redundantie wordt tijdens de storing hersteld”. Ook met Ceph kan een getroffen VM stoppen en pas op een andere host herstarten; nul seconden onderbreking volgt daar niet uit.
Bereken capaciteit met uitvalreserve
Stel dat elke host vier lokale gegevens-SSD’s van elk 1,92 TB decimaal heeft. Drie hosts leveren 23,04 TB bruto, vier 30,72 TB. Met drie kopieën is dat vóór metadata, snapshots en beheerreserves theoretisch 7,68 of 10,24 TB logisch. Een hypothetische planningsgrens van 70 procent geeft eerst 5,38 of 7,17 TB. Dit is geen Ceph-standaardwaarde of toegezegd bruikbaar volume.
| Controlepunt | 3 hosts | 4 hosts |
|---|---|---|
| Bruto / theoretisch logisch | 23,04 / 7,68 TB | 30,72 / 10,24 TB |
| 70 % van theoretische logische capaciteit | 5,38 TB | 7,17 TB |
| Na uitval van één host | Twee hostkopieën; derde pas na vervanging | Derde kopie mogelijk op de drie resterende hosts |
| 70%-grens na herbouw op 3 hosts | Niet haalbaar zonder derde host | 23,04 ÷ 3 × 0,70 = 5,38 TB |
Wie het vierhostcluster ook na hostuitval, nadat de herbouw is voltooid, onder de zelfgekozen grens van 70 procent wil houden, plant in dit voorbeeld hoogstens ongeveer 5,38 TB logische gegevens, geen 7,17 TB. Ook de volste OSD’s en Ceph-drempels voor nearfull, backfillfull en fullzijn bepalend. Eén volle OSD kan schrijven of backfill blokkeren terwijl het totaal er goed uitziet. Decimale TB zijn geen binaire TiB.
Hoelang duurt de herbouw?
Met bijvoorbeeld 5 TB logische gegevens en drie kopieën bevat het vierhostcluster 15 TB bruto, idealiter gelijkmatig 3,75 TB per host. Bij uitval van één moet voor de derde kopie circa 3,75 TB naar de drie resterende hosts worden overgedragen. Bij een gemeten effectieve herbouwsnelheid van 250 MB/s is 3,75 TB ÷ 250 MB/s = ongeveer 4 uur 10 minuten een rekenkundige ondergrens; bij 125 MB/s ongeveer 8 uur 20 minuten. Peering, verdeling, concurrerende VM-I/O, recoverylimieten en nieuwe schrijflast verlengen de echte tijd. De nominale snelheid van een 25-Gbit-kaart is hiervoor geen meetwaarde.
DAXS zou een uitvaltest onder actieve applicatiebelasting vragen: observeer ceph health detail, ceph osd df en het verloop van placement groups, registreer daadwerkelijke recoverybytes en duur en meet latency en VM-beschikbaarheid. Bij normale werking moeten PG’s weer active+clean bereiken. De test moet ook tonen of uitval van switch, link of voedingspad het Corosync-quorum of Ceph-verkeer tegelijk raakt. Proxmox adviseert minstens 10 Gbit/s exclusief voor Ceph en meer bij snelle SSD’s; het poortplan hangt af van OSD-doorvoer, hersteldoel en fysiek gescheiden paden.
Wat kost het extra storingsdomein voor herbouw?
Voor de budgetbeslissing staat h voor de offerteprijs van een volledig uitgeruste host, n voor het redundante netwerk dat al op vier aansluitingen is berekend en b voor een externe back-upserver inclusief media. Per host nemen we jaarlijks p euro voor service, stroom en colocatie aan. Alleen in dit model rekenen we voor opbouw en acceptatie 100 uur × 90 € = 9.000 € en voor doorlopend beheer 60 uur × 90 € = 5.400 € per jaar. Voor drie en vier hosts wordt hetzelfde werk aangenomen; dit moet in de concrete offerte opnieuw worden geschat. De officiële catalogusprijzen voor Proxmox VE Standard en één Proxmox Backup Server Standard zijn respectievelijk 550 € per bezette CPU-socket per jaar en 2.240 € per back-upserver per jaar. Elke host heeft aangenomen precies één bezette socket. Alles is netto; vervang door echte offertes en werkramingen.
| Optie | 3 jaar | 5 jaar |
|---|---|---|
| 3 hosts | 3h + n + b + 36.870 + 9p € | 3h + n + b + 55.450 + 15p € |
| 4 hosts | 4h + n + b + 38.520 + 12p € | 4h + n + b + 58.200 + 20p € |
| Meerprijs voor de 4e host | h + 1.650 + 3p € | h + 2.750 + 5p € |
De formule telt jaarlijks Proxmox-sockets, PBS en 5.400 € beheer op: bij drie hosts 9.290 € plus 3p, bij vier 9.840 € plus 4p. Een 1.000 € hogere stukprijs per host verhoogt beide vierhosthorizonten met 4.000 €; 1.000 € hogere jaarlijkse kosten per host met 12.000 of 20.000 €. Vereist de vierhostoptie andere switches, tel het verschil dan op bij n . Ceph-kopieën blijven geen back-up: een apart systeem, externe kopie en geteste restore horen bij acceptatie. Het DAXS-artikel Proxmox Backup Server: verificatie, bewaring en herstel beschrijft deze controle.
De keuze volgt pas na meting van latency, uitval- en herbouwtijd en een onderbouwde offerte voor hardware, netwerk en beheer. DAXS kan dit meet- en acceptatieprotocol met het bedrijf concretiseren via Contact .
Bronnen: Proxmox VE Administration Guide: cluster en Ceph · Ceph: size en min_size · Ceph: gezondheidscontroles en vulling · Ceph: recovery en backfill · Proxmox VE: prijzen · Proxmox Backup Server: prijzen.