Ceph, ZFS-replicatie en een extern SAN of NAS kunnen Proxmox-VM’s door hostuitval helpen. Ze verschillen echter in actualiteit van gegevens, herstart en storingsdomein. Alleen “hoge beschikbaarheid” aanvinken kan de echte eis verbergen: hoeveel minuten gegevensverlies verdraagt de applicatie (RPO) en wanneer moet ze weer bruikbaar zijn (RTO)?
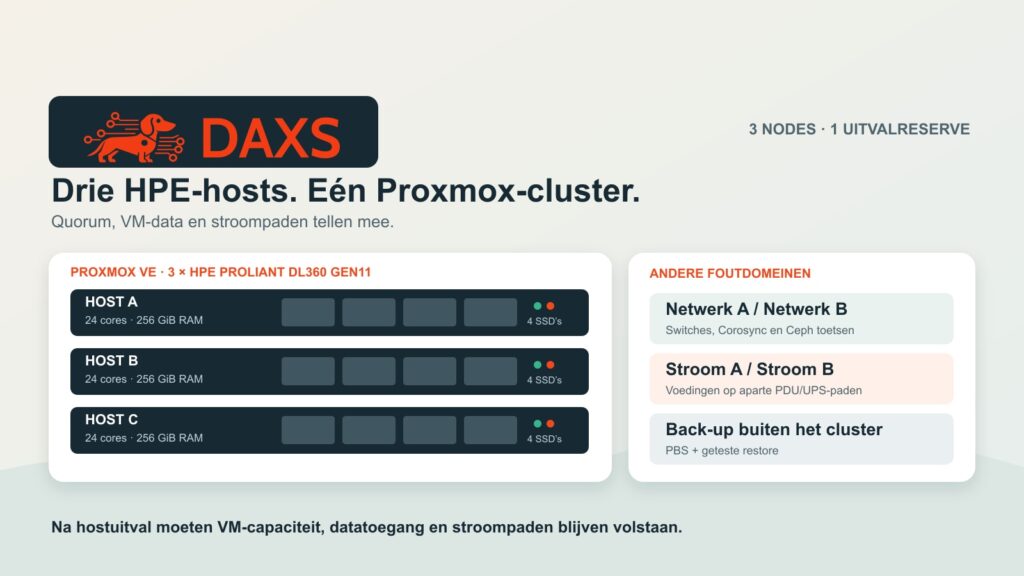
We vergelijken drie opslagroutes voor hetzelfde hypothetische cluster met drie hosts. Hoe Ceph kopieën na hostuitval herbouwt is afzonderlijk beschreven. Deze keuze begint bij applicaties en hun aantoonbare hersteldoelen. Aparte back-up met een hersteltest blijft voor alle routes daarnaast vereist.
Drie architecturen, drie verschillende uitvalroutes
Ceph op lokale SSD’s biedt de VM-schijf als gedistribueerde blokopslag die in het hele cluster bereikbaar is. In een gerepliceerde pool staan kopieën op meerdere hosts; quorum, poolregel, netwerk en vrije capaciteit moeten passen bij het gekozen hoststoringsdomein. Na uitval van een VM-host kan Proxmox HA de VM elders herstarten als quorum en middelen beschikbaar zijn. Een lopende schrijfactie, gastapplicatie en transacties moeten toch in de uitvaltest worden beoordeeld. Alleen Ceph-redundantie belooft geen ononderbroken VM of gegarandeerde RPO nul voor iedere applicatie.
Lokaal ZFS met Proxmox-opslagreplicatie brengt VM-volumes periodiek via snapshots naar een andere host. Het doel heeft de stand van de laatst succesvol voltooide replicatie. Proxmox staat HA met deze replicatie toe, maar waarschuwt expliciet voor gegevensverlies sinds de laatste synchronisatie. Een ingesteld vijfminuteninterval is dus geen algemene RPO-toezegging: vertraging, mislukte taken en applicatiestatus tellen mee. Zonder synchrone gedeelde schijf moet de herstartte VM precies die oudere stand aankunnen.
Externe gedeelde opslag zoals NFS of iSCSI maakt VM-schijven voor meerdere hosts bereikbaar en laat meestal live migratie zonder schijfkopie toe. Bij hostuitval hangt het gegevensrisico af van het echte opslagontwerp. Controleer twee controllers, gescheiden data- en voedingspaden, iSCSI-multipathing of redundante NFS-netwerkpaden, support en geteste controllerfailover; één NAS blijft een centraal storingsdomein. Proxmox waarschuwt expliciet dat een ZFS-over-iSCSI-appliance geen single point of failure mag worden. “Shared” in de configuratie bewijst geen redundante appliance.
Welke workload verdraagt welke RPO en RTO?
RPO meet het maximaal geaccepteerde gegevensverlies; RTO de maximale tijd totdat de applicatie bruikbaar is. De volgende punten zijn beslissingsvragen, geen product-SLA’s. Test voor elke dienst database, VM-herstart, DNS, gebruikerslogin en afhankelijke systemen samen.
| Applicatie en doel | Aannemelijke route | Beslissende controle |
|---|---|---|
| Transactionele ERP-database; nauwelijks gegevensverlies aanvaardbaar | Ceph of aantoonbaar redundante gedeelde opslag; mogelijk aanvullende applicatiereplicatie | Schrijflatency, transactieconsistentie, quorum en echte herstart bij host-/opslagstoring |
| Interne test-VM of herstelbare webdienst; minuten gegevensverlies geaccepteerd | Lokaal ZFS met replicatie kan volstaan | Leeftijd laatste geslaagde snapshot, melding bij vertraging, starten met oudere gegevens |
| Bestaand ondersteund SAN/NAS met voldoende reserve | Hergebruik als gedeelde opslag kan economisch zijn | Test controllers, paden, voeding, firmware, onderhoudscontract en live failover samen |
Voor een productiedatabase met zeer strakke RPO kan asynchrone ZFS-replicatie ongeschikt zijn, zelfs als HA-herstart werkt. Een herstelbare testdienst rechtvaardigt omgekeerd niet automatisch Ceph. Drie Proxmox-hosts maken één opslagserver niet redundant. De keuze volgt geaccepteerd gegevensverlies en gemeten onderbreking, verder dan de productnaam.
Drie- en vijfjaarsberekening zonder verzonnen marktprijzen
De hypothetische vergelijking gebruikt drie identieke hosts met één socket, aanschafprijs h per host en een aparte back-upserver inclusief media tegen prijs b . Volgens de actuele fabrikantlijst kost Proxmox VE Standard 550 € per bezette CPU-socket per jaar; Proxmox Backup Server Standard 2.240 € per server per jaar. De gezamenlijke support is dus 3 × 550 + 2.240 = 3.890 € jaarlijks. Het model rekent 90 € netto per werkuur. Het neemt geen gelijke IOPS of bruikbare capaciteit aan zonder controle: echte offertes moeten eerst op dezelfde workload worden genormaliseerd.
d staat voor extra Ceph-gegevens-SSD’s per host, z voor lokale ZFS-SSD-uitrusting per host, a voor een redundant ontworpen externe appliance, nc, nz en ns voor de per route nodige netwerk- of fabricinvesteringen. ec, ez en es zijn jaarlijkse extra stroom-/colocatiekosten; s is het jaarlijkse fabrikantservicecontract van de externe appliance. Alle letters zijn netto offertebedragen in euro’s, geen beweerde marktprijzen.
| Route | Opbouw / jaarlijks beheer | 3 jaar | 5 jaar |
|---|---|---|---|
| Ceph | 80 h / 50 h | 3h + b + 3d + nc + 32.370 + 3ec € | 3h + b + 3d + nc + 49.150 + 5ec € |
| ZFS-replicatie | 50 h / 30 h | 3h + b + 3z + nz + 24.270 + 3ez € | 3h + b + 3z + nz + 37.450 + 5ez € |
| Externe opslag | 60 h / 35 h | 3h + b + a + ns + 26.520 + 3s + 3es € | 3h + b + a + ns + 40.600 + 5s + 5es € |
Werkuren zijn uitsluitend modelaannames, geen DAXS-pakketprijs. Voorbeeld: 1.000 € meer jaarlijkse applianceservice verhoogt de externe optie over drie jaar met 3.000 € en over vijf jaar met 5.000 €. Een bestaande appliance kan a binnen de periode verlagen, maar resterende levensduur, support, onderdelen en uitbreiding horen in s of een apart investeringsveld. Hardwareprijzen, opslaggebruik, prestatieprofiel, netwerk, belasting en beheerlocatie moeten met offertes worden onderbouwd. De laagste formulewaarde beslist geen aankoop zonder gelijke bruikbare capaciteit, IOPS, RPO en RTO.
Acceptatie: speel één uitval per storingsdomein echt door
DAXS zou per geschikte architectuur vier bewijzen vragen: (1) leg het tijdstip van de laatste consistente applicatiestand vast, (2) meet hostuitval en VM-herstart met belasting, (3) laat ook het kritieke opslag- of netwerkpad gericht uitvallen en (4) herstel een VM en losse applicatiegegevens vanuit aparte back-up. Neem bij ZFS een mislukte of vertraagde replicatietaak mee; bij Ceph de gedegradeerde pool en herbouw; bij SAN/NAS de controller- en padwissel. Metingen bepalen of RPO en RTO worden gehaald.
Ceph-kopieën, replicatiesnapshots en arraymirroring verspreiden ook verwijderingen en foutieve gegevens. Ze vervangen geen versiebeheer, externe kopie of hersteltest. Het DAXS-artikel Proxmox Backup Server: verificatie, bewaring en herstel verdiept back-upacceptatie. Met een applicatielijst en RPO/RTO-doelen kun je via Contact met DAXS de drie routes aan echte belasting en bestaande contracten laten meten.
Bronnen: Proxmox VE Administration Guide: opslag, opslagreplicatie en HA · Proxmox VE: actuele supportprijzen · Proxmox Backup Server: actuele supportprijzen.